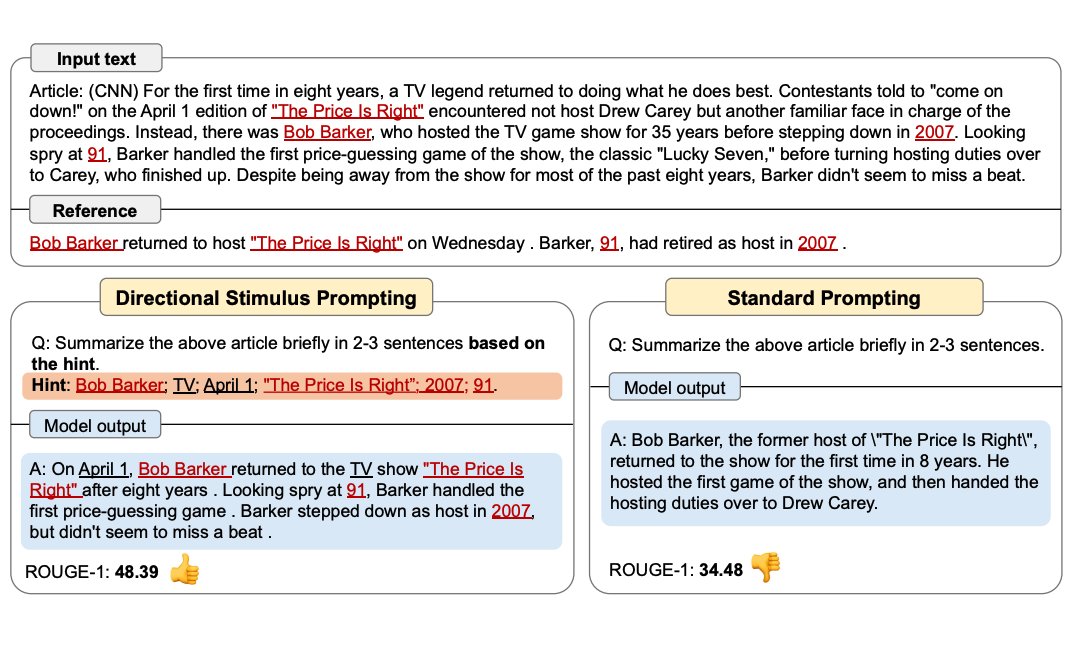
Li et al., (2023) mengusulkan teknik prompting baru untuk memandu LLM dengan lebih baik dalam menghasilkan ringkasan yang diinginkan.
Sebuah policy LM yang bisa disetel (tuneable) dilatih untuk menghasilkan stimulus/petunjuk (hint). Penggunaan RL untuk mengoptimalkan LLM makin sering terlihat.
Gambar di bawah ini menunjukkan perbandingan Directional Stimulus Prompting dengan prompting standar. Policy LM bisa berukuran kecil dan dioptimalkan untuk menghasilkan petunjuk yang memandu LLM beku (frozen) yang bersifat black-box.