Learning / Teknik Prompting
Reflexion
Reflexion adalah kerangka kerja untuk memperkuat agen berbasis bahasa melalui umpan balik linguistik. Menurut Shinn et al. (2023), "Reflexion adalah paradigma baru untuk reinforcement 'verbal' yang memparameterkan sebuah policy sebagai encoding memori agen yang dipasangkan dengan pilihan parameter LLM."
Secara garis besar, Reflexion mengubah umpan balik dari lingkungan (environment), baik berupa bahasa bebas maupun nilai skalar, menjadi umpan balik linguistik, yang juga disebut refleksi diri (self-reflection). Umpan balik ini diberikan sebagai konteks untuk agen LLM pada episode berikutnya. Cara ini membantu agen belajar dengan cepat dan efektif dari kesalahan sebelumnya, sehingga performanya meningkat pada banyak tugas tingkat lanjut.
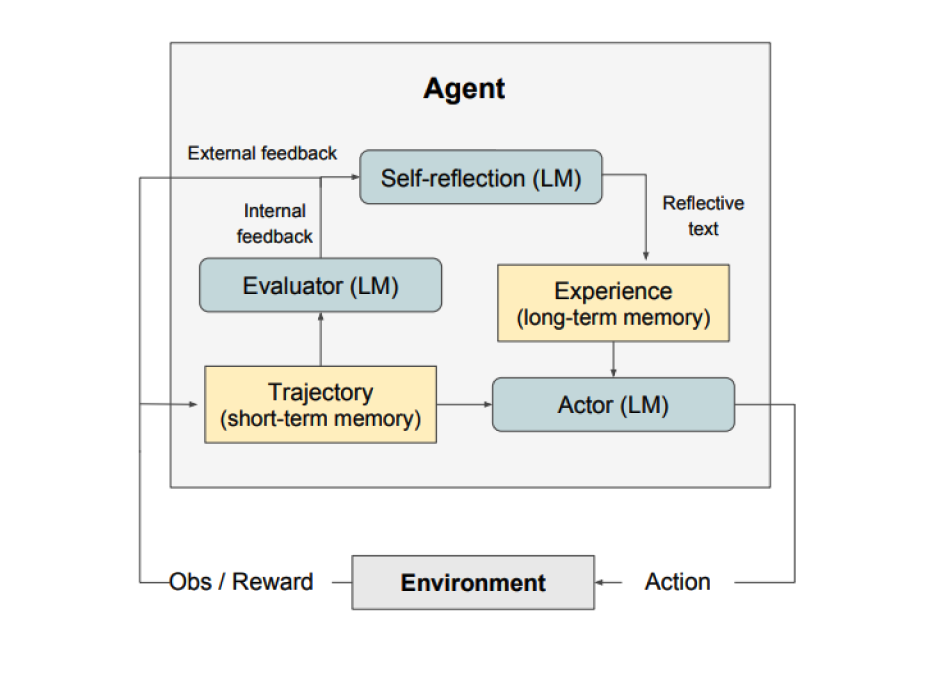
Seperti terlihat pada gambar di atas, Reflexion terdiri dari tiga model yang berbeda:
- Actor: Menghasilkan teks dan aksi berdasarkan observasi keadaan (state). Actor mengambil aksi di dalam sebuah lingkungan dan menerima observasi, yang kemudian membentuk sebuah lintasan (trajectory). Chain-of-Thought (CoT) dan ReAct dipakai sebagai model Actor. Komponen memori juga ditambahkan untuk memberi konteks tambahan kepada agen.
- Evaluator: Memberi skor pada output yang dihasilkan Actor. Lebih tepatnya, Evaluator menerima input berupa lintasan yang dihasilkan (disebut juga memori jangka pendek) dan mengeluarkan skor reward. Fungsi reward yang dipakai berbeda-beda tergantung tugasnya (LLM dan heuristik berbasis aturan dipakai untuk tugas pengambilan keputusan).
- Self-Reflection: Menghasilkan isyarat penguatan (reinforcement) verbal untuk membantu Actor memperbaiki diri. Peran ini dijalankan oleh sebuah LLM dan memberikan umpan balik berharga untuk percobaan berikutnya. Untuk menghasilkan umpan balik yang spesifik dan relevan, yang juga disimpan di memori, model self-reflection memanfaatkan sinyal reward, lintasan saat ini, dan memori persistennya. Pengalaman-pengalaman ini (disimpan di memori jangka panjang) dimanfaatkan agen untuk memperbaiki pengambilan keputusan dengan cepat.
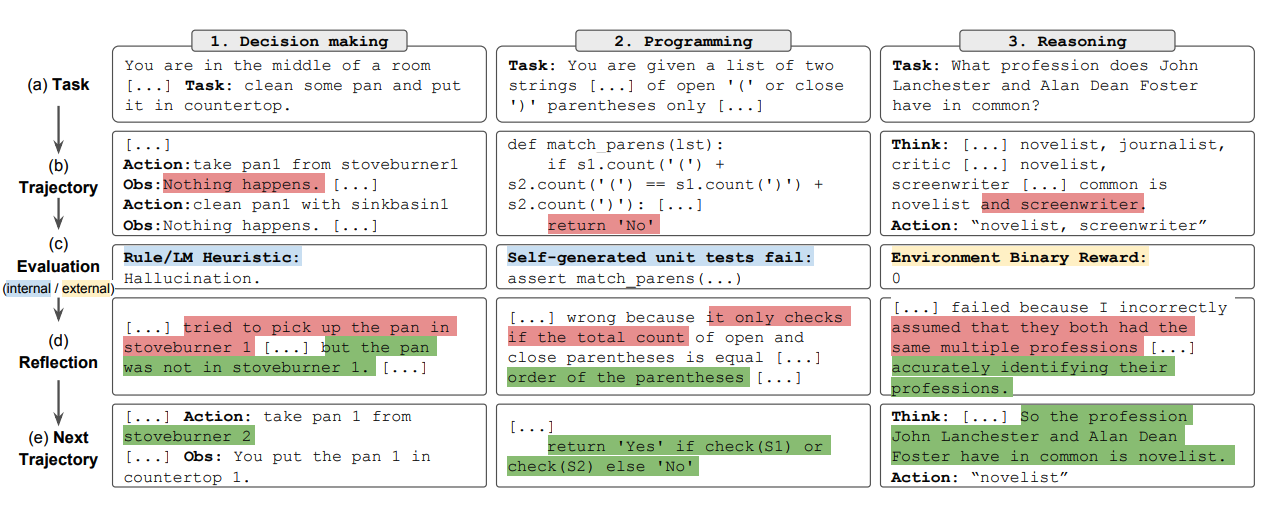
Ringkasnya, langkah-langkah utama proses Reflexion adalah a) menentukan tugas, b) menghasilkan lintasan, c) mengevaluasi, d) melakukan refleksi, dan e) menghasilkan lintasan berikutnya. Gambar di bawah menunjukkan contoh bagaimana agen Reflexion bisa belajar mengoptimalkan perilakunya secara berulang (iteratif) untuk menyelesaikan berbagai tugas seperti pengambilan keputusan, pemrograman, dan penalaran. Reflexion memperluas kerangka kerja ReAct dengan menambahkan komponen evaluasi diri (self-evaluation), refleksi diri (self-reflection), dan memori.
Hasil
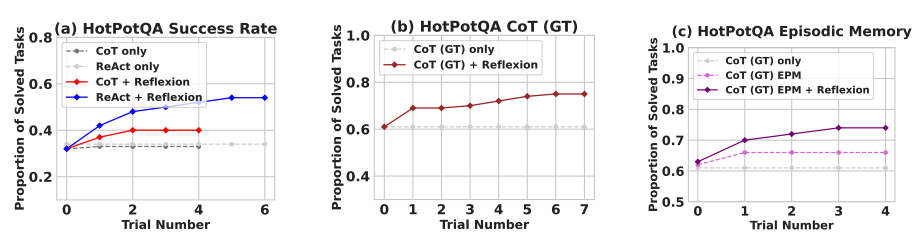
Hasil eksperimen menunjukkan bahwa agen Reflexion meningkatkan performa secara signifikan pada tugas pengambilan keputusan AlfWorld, soal penalaran di HotPotQA, dan tugas pemrograman Python di HumanEval.
Saat dievaluasi pada tugas pengambilan keputusan berurutan (AlfWorld), ReAct + Reflexion jauh mengungguli ReAct dengan menyelesaikan 130 dari 134 tugas, menggunakan teknik evaluasi diri berupa Heuristic dan GPT untuk klasifikasi biner.
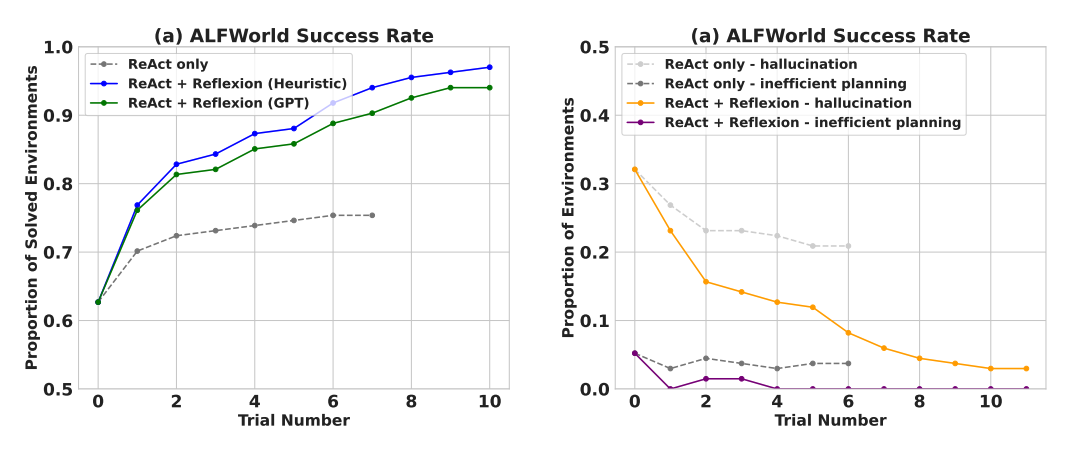
Reflexion jauh mengungguli semua pendekatan baseline di sepanjang beberapa langkah pembelajaran. Untuk penalaran saja, dan saat ditambahkan memori episodik yang berisi lintasan terbaru, Reflexion + CoT masing-masing mengungguli CoT saja dan CoT dengan memori episodik.
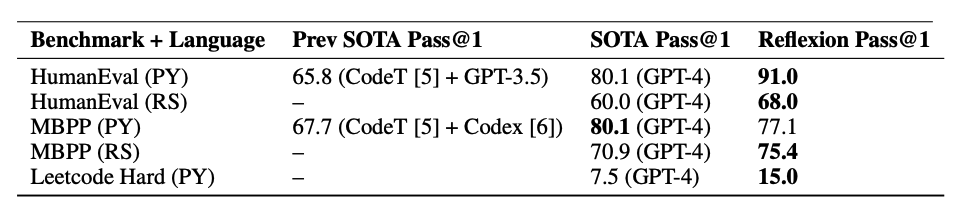
Seperti dirangkum pada tabel di bawah, Reflexion umumnya mengungguli pendekatan state-of-the-art sebelumnya dalam penulisan kode Python dan Rust pada MBPP, HumanEval, dan Leetcode Hard.
Kapan Sebaiknya Memakai Reflexion?
Reflexion paling cocok untuk situasi berikut:
- Agen perlu belajar dari coba-coba (trial and error): Reflexion dirancang untuk membantu agen meningkatkan performanya dengan merefleksikan kesalahan masa lalu dan memasukkan pengetahuan itu ke dalam keputusan berikutnya. Karena itu, Reflexion cocok untuk tugas di mana agen perlu belajar lewat coba-coba, seperti pengambilan keputusan, penalaran, dan pemrograman.
- Metode reinforcement learning tradisional tidak praktis: Metode reinforcement learning (RL) tradisional sering membutuhkan data pelatihan dalam jumlah besar dan fine-tuning model yang mahal. Reflexion menawarkan alternatif ringan yang tidak memerlukan fine-tuning pada model bahasa yang mendasarinya, sehingga lebih efisien dari sisi data dan sumber daya komputasi.
- Dibutuhkan umpan balik yang bernuansa: Reflexion memakai umpan balik verbal, yang bisa lebih bernuansa dan spesifik dibanding reward skalar yang dipakai pada RL tradisional. Ini membuat agen lebih memahami kesalahannya dan bisa melakukan perbaikan yang lebih terarah pada percobaan berikutnya.
- Interpretabilitas dan memori eksplisit itu penting: Dibanding metode RL tradisional, Reflexion menyediakan bentuk memori episodik yang lebih mudah ditafsirkan dan lebih eksplisit. Refleksi diri agen disimpan di memorinya, sehingga proses belajarnya lebih mudah dianalisis dan dipahami.
Reflexion efektif untuk tugas-tugas berikut:
- Pengambilan keputusan berurutan: Agen Reflexion meningkatkan performanya pada tugas AlfWorld, yang melibatkan navigasi melalui berbagai lingkungan dan menyelesaikan tujuan multi-langkah.
- Penalaran: Reflexion meningkatkan performa agen pada HotPotQA, dataset tanya-jawab yang menuntut penalaran atas banyak dokumen.
- Pemrograman: Agen Reflexion menulis kode yang lebih baik pada benchmark seperti HumanEval dan MBPP, bahkan mencapai hasil state-of-the-art pada beberapa kasus.
Berikut beberapa keterbatasan Reflexion:
- Bergantung pada kemampuan evaluasi diri: Reflexion mengandalkan kemampuan agen untuk menilai performanya secara akurat dan menghasilkan refleksi diri yang berguna. Hal ini bisa menantang, terutama untuk tugas yang kompleks, tetapi Reflexion diperkirakan akan makin baik seiring kemampuan model yang terus meningkat.
- Batasan memori jangka panjang: Reflexion memakai sliding window dengan kapasitas maksimum, tetapi untuk tugas yang lebih kompleks mungkin lebih menguntungkan memakai struktur yang lebih canggih seperti vector embedding atau database SQL.
- Keterbatasan pembuatan kode: Ada keterbatasan pada test-driven development dalam menentukan pemetaan input-output yang akurat (misalnya fungsi generator yang non-deterministik dan output fungsi yang dipengaruhi perangkat keras).
Sumber gambar: Reflexion: Language Agents with Verbal Reinforcement Learning