Learning / Teknik Prompting
Tree of Thoughts (ToT)
Untuk tugas kompleks yang butuh eksplorasi atau perencanaan strategis ke depan (lookahead), teknik prompting tradisional atau sederhana kurang memadai. Yao et el. (2023) dan Long (2023) baru-baru ini mengusulkan Tree of Thoughts (ToT), sebuah framework yang memperluas chain-of-thought prompting dan mendorong eksplorasi atas "pikiran" (thoughts) yang berfungsi sebagai langkah perantara untuk pemecahan masalah umum dengan model bahasa.
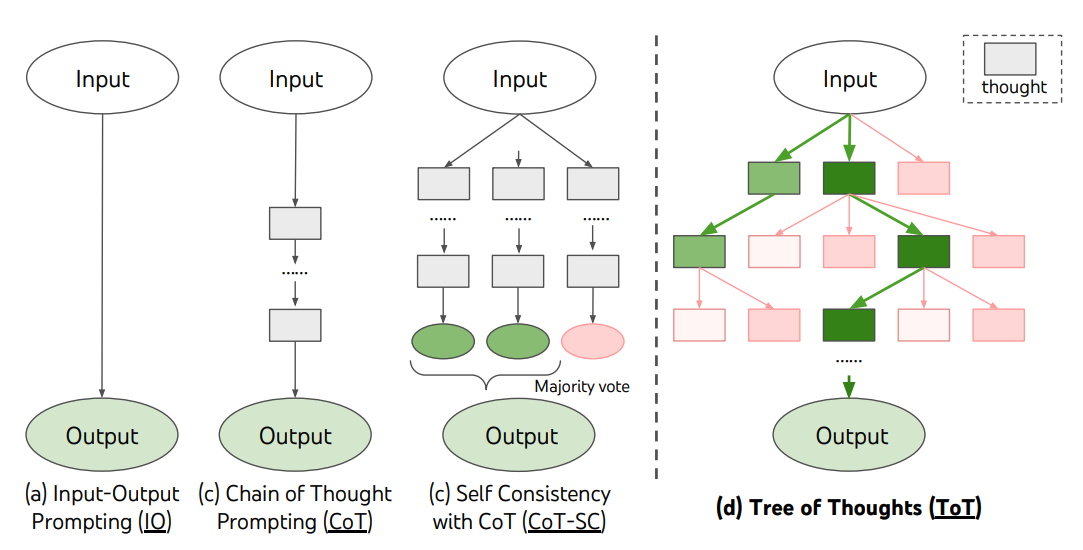
ToT memelihara sebuah pohon pikiran, di mana setiap pikiran adalah rangkaian bahasa yang koheren dan berfungsi sebagai langkah perantara menuju penyelesaian masalah. Pendekatan ini memungkinkan model bahasa (LM) mengevaluasi sendiri kemajuan yang sudah dicapai lewat pikiran-pikiran perantara itu melalui proses penalaran yang disengaja. Kemampuan LM untuk menghasilkan dan mengevaluasi pikiran kemudian digabungkan dengan algoritma pencarian (misalnya breadth-first search dan depth-first search) sehingga eksplorasi pikiran bisa dilakukan secara sistematis, lengkap dengan lookahead dan backtracking.
Framework ToT digambarkan di bawah ini:
Sumber gambar: Yao et el. (2023)
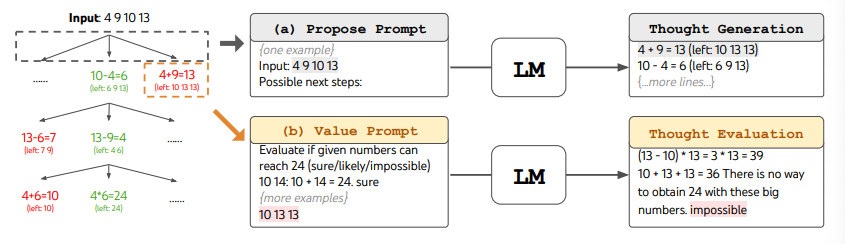
Saat memakai ToT, tiap tugas perlu menentukan jumlah kandidat dan jumlah pikiran/langkah. Misalnya, seperti ditunjukkan di paper, Game of 24 dipakai sebagai tugas penalaran matematis yang mengharuskan pikiran dipecah menjadi 3 langkah, masing-masing berisi satu persamaan perantara. Di setiap langkah, b=5 kandidat terbaik dipertahankan.
Untuk menjalankan BFS di ToT pada tugas Game of 24, LM diberi prompt untuk mengevaluasi tiap kandidat pikiran sebagai "pasti/mungkin/mustahil" (sure/maybe/impossible) dalam hal mencapai 24. Menurut para penulisnya, "tujuannya adalah mempromosikan solusi parsial yang benar yang bisa dipastikan dalam beberapa percobaan lookahead, menyingkirkan solusi parsial yang mustahil berdasarkan akal sehat (commonsense) 'terlalu besar/kecil', dan mempertahankan sisanya sebagai 'mungkin'". Nilai diambil (sampling) 3 kali untuk setiap pikiran. Prosesnya digambarkan di bawah ini:
Sumber gambar: Yao et el. (2023)
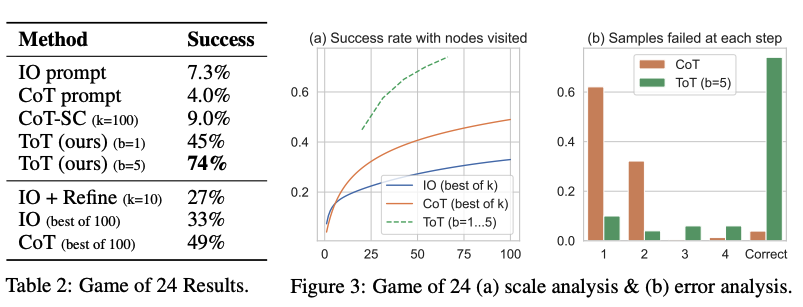
Dari hasil yang dilaporkan pada gambar di bawah, ToT jauh mengungguli metode prompting lainnya:
Sumber gambar: Yao et el. (2023)
Kode tersedia di sini dan di sini
Secara garis besar, ide utama Yao et el. (2023) dan Long (2023) mirip. Keduanya meningkatkan kemampuan LLM dalam memecahkan masalah kompleks lewat pencarian pohon (tree search) melalui percakapan beberapa putaran. Salah satu perbedaan utamanya: Yao et el. (2023) memanfaatkan DFS/BFS/beam search, sedangkan strategi pencarian pohon (yaitu kapan harus backtrack dan mundur berapa level, dst.) yang diusulkan di Long (2023) dikendalikan oleh "ToT Controller" yang dilatih lewat reinforcement learning. DFS/BFS/Beam search adalah strategi pencarian solusi generik yang tidak beradaptasi dengan masalah tertentu. Sebagai perbandingan, ToT Controller yang dilatih lewat RL mungkin bisa belajar dari dataset baru atau lewat self-play (AlphaGo vs pencarian brute force), sehingga sistem ToT berbasis RL bisa terus berkembang dan mempelajari pengetahuan baru bahkan dengan LLM yang tetap.
Hulbert (2023) mengusulkan Tree-of-Thought Prompting, yang menerapkan konsep utama framework ToT sebagai teknik prompting sederhana, yaitu membuat LLM mengevaluasi pikiran-pikiran perantara dalam satu prompt. Contoh prompt ToT:
Bayangkan tiga ahli yang berbeda sedang menjawab pertanyaan ini.
Semua ahli akan menuliskan 1 langkah pemikiran mereka,
lalu membagikannya ke kelompok.
Kemudian semua ahli lanjut ke langkah berikutnya, dst.
Jika ada ahli yang sadar dirinya salah di titik mana pun, ia keluar.
Pertanyaannya adalah...
Sun (2023) menguji (benchmark) Tree-of-Thought Prompting dengan eksperimen berskala besar, dan memperkenalkan PanelGPT, sebuah ide prompting dengan diskusi panel antar-LLM.