Learning / Teknik Prompting
Retrieval Augmented Generation (RAG)
Model bahasa serbaguna bisa di-fine-tuning untuk mengerjakan beberapa tugas umum seperti analisis sentimen dan pengenalan entitas bernama (named entity recognition). Tugas-tugas ini umumnya tidak membutuhkan pengetahuan latar tambahan.
Untuk tugas yang lebih kompleks dan padat pengetahuan, kamu bisa membangun sistem berbasis model bahasa yang mengakses sumber pengetahuan eksternal untuk menyelesaikan tugas. Cara ini membuat jawaban lebih konsisten secara fakta, meningkatkan keandalan respons yang dihasilkan, dan membantu mengurangi masalah "halusinasi".
Peneliti Meta AI memperkenalkan metode bernama Retrieval Augmented Generation (RAG) untuk menangani tugas-tugas padat pengetahuan seperti ini. RAG menggabungkan komponen pencarian informasi (information retrieval) dengan model penghasil teks. RAG bisa di-fine-tuning, dan pengetahuan internalnya bisa diubah secara efisien tanpa perlu melatih ulang seluruh model.
RAG menerima input lalu mengambil (retrieve) sekumpulan dokumen yang relevan/pendukung dari suatu sumber (misalnya Wikipedia). Dokumen-dokumen itu digabungkan sebagai konteks bersama prompt input asli, lalu diberikan ke model penghasil teks yang membuat output akhir. Ini membuat RAG mudah beradaptasi untuk situasi di mana fakta bisa berubah seiring waktu. Hal ini sangat berguna karena pengetahuan parametrik LLM bersifat statis. RAG memungkinkan model bahasa tidak perlu dilatih ulang, sehingga bisa mengakses informasi terbaru untuk menghasilkan output yang andal lewat generasi berbasis retrieval.
Lewis et al., (2021) mengusulkan resep fine-tuning serbaguna untuk RAG. Model seq2seq yang sudah dilatih sebelumnya (pre-trained) dipakai sebagai memori parametrik, dan indeks vektor padat (dense vector index) dari Wikipedia dipakai sebagai memori non-parametrik (diakses menggunakan neural retriever yang sudah dilatih sebelumnya). Berikut gambaran cara kerja pendekatan ini:
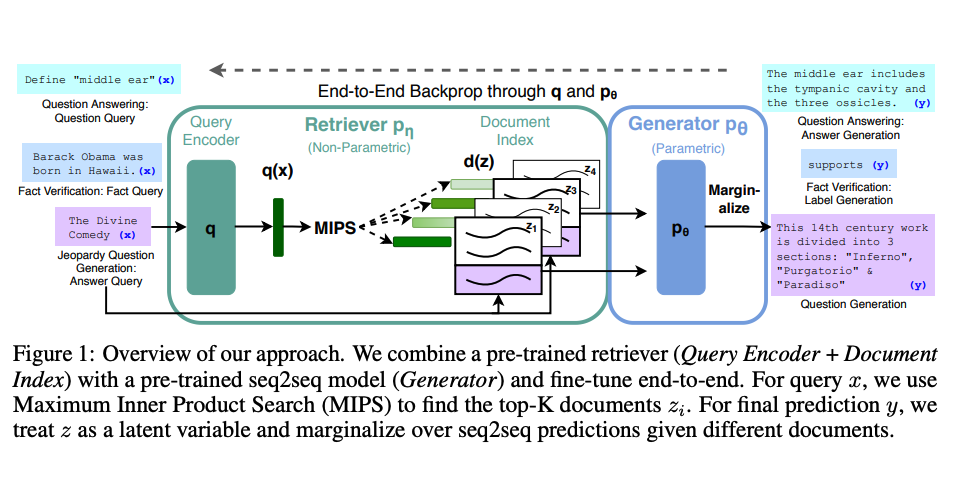
Sumber gambar: Lewis et el. (2021)
RAG berkinerja kuat di beberapa benchmark seperti Natural Questions, WebQuestions, dan CuratedTrec. RAG menghasilkan respons yang lebih faktual, spesifik, dan beragam saat diuji pada pertanyaan MS-MARCO dan Jeopardy. RAG juga memperbaiki hasil pada verifikasi fakta FEVER.
Ini menunjukkan potensi RAG sebagai pilihan yang layak untuk meningkatkan output model bahasa pada tugas-tugas padat pengetahuan.
Belakangan ini, pendekatan berbasis retriever seperti ini makin populer dan digabungkan dengan LLM populer seperti ChatGPT untuk meningkatkan kemampuan dan konsistensi faktanya.
Contoh Penggunaan RAG: Membuat Judul Paper ML yang Ramah
Di bawah ini, kami sudah menyiapkan tutorial notebook yang menunjukkan penggunaan LLM open-source untuk membangun sistem RAG yang menghasilkan judul paper machine learning yang singkat dan padat:
Notebook gratisMulai Menggunakan RAG