Learning / Teknik Prompting
ReAct Prompting
Yao et al., 2022 memperkenalkan sebuah kerangka kerja bernama ReAct, di mana LLM dipakai untuk menghasilkan jejak penalaran (reasoning traces) sekaligus aksi yang spesifik untuk tugas secara bergantian.
Dengan menghasilkan jejak penalaran, model bisa menyusun, memantau, dan memperbarui rencana aksinya, bahkan menangani pengecualian (exception). Langkah aksi memungkinkan model terhubung dan mengumpulkan informasi dari sumber eksternal seperti basis pengetahuan atau lingkungan (environment).
Kerangka kerja ReAct memungkinkan LLM berinteraksi dengan tool eksternal untuk mengambil informasi tambahan, sehingga menghasilkan respons yang lebih andal dan faktual.
Hasilnya menunjukkan bahwa ReAct bisa mengungguli beberapa baseline state-of-the-art pada tugas bahasa dan tugas pengambilan keputusan. ReAct juga membuat LLM lebih mudah dipahami (interpretabilitas) dan lebih bisa dipercaya oleh manusia. Secara keseluruhan, para penulis menemukan bahwa pendekatan terbaik adalah ReAct yang digabungkan dengan chain-of-thought (CoT), sehingga model bisa memakai pengetahuan internalnya sekaligus informasi eksternal yang diperoleh selama proses penalaran.
Bagaimana Cara Kerjanya?
ReAct terinspirasi dari sinergi antara "bertindak" (acting) dan "bernalar" (reasoning) yang memungkinkan manusia mempelajari tugas baru serta membuat keputusan atau melakukan penalaran.
Chain-of-thought (CoT) prompting sudah menunjukkan kemampuan LLM dalam menjalankan jejak penalaran untuk menjawab pertanyaan yang melibatkan aritmetika dan penalaran akal sehat (commonsense), di antara tugas-tugas lainnya (Wei et al., 2022). Namun, karena tidak punya akses ke dunia luar atau tidak bisa memperbarui pengetahuannya, CoT bisa mengalami masalah seperti halusinasi fakta dan perambatan kesalahan (error propagation).
ReAct adalah paradigma umum yang menggabungkan penalaran dan aksi dengan LLM. ReAct mendorong LLM untuk menghasilkan jejak penalaran verbal dan aksi untuk sebuah tugas. Dengan begitu, sistem bisa melakukan penalaran dinamis untuk membuat, menjaga, dan menyesuaikan rencana aksi, sekaligus berinteraksi dengan lingkungan eksternal (misalnya Wikipedia) untuk memasukkan informasi tambahan ke dalam penalarannya. Gambar di bawah menunjukkan contoh ReAct beserta langkah-langkah yang dilakukan untuk menjawab pertanyaan (question answering).
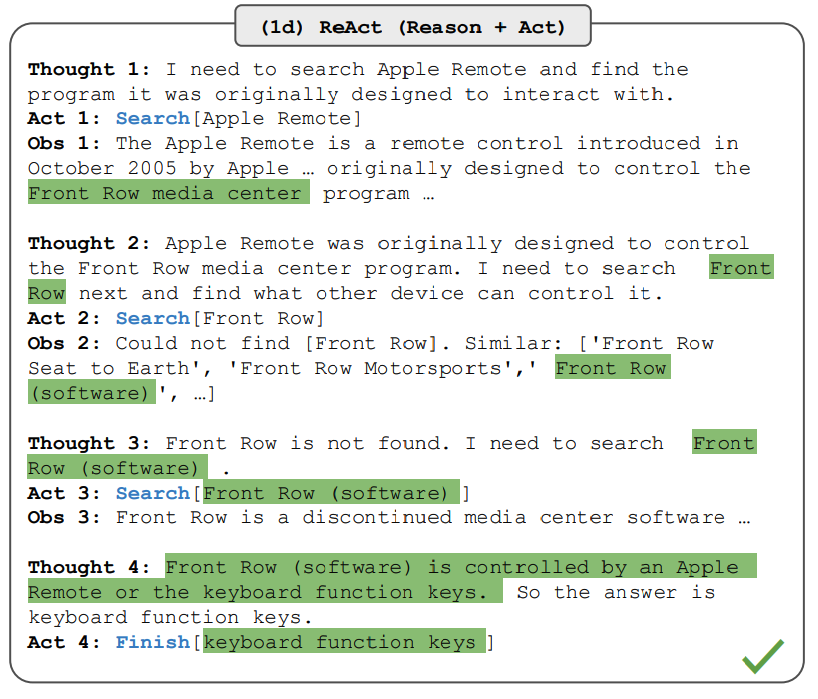
Sumber gambar: Yao et al., 2022
Pada contoh di atas, kita memberikan prompt seperti pertanyaan berikut dari HotpotQA:
Aside from the Apple Remote, what other devices can control the program Apple Remote was originally designed to interact with?Contoh ini dibiarkan dalam bahasa Inggris karena merupakan pertanyaan asli dari dataset HotpotQA dan sesuai dengan isi gambar di atas.
Perlu dicatat bahwa contoh dalam konteks (in-context examples) juga ditambahkan ke prompt, tetapi tidak kita tampilkan di sini supaya lebih sederhana. Kita bisa lihat bahwa model menghasilkan lintasan penyelesaian tugas (task solving trajectories), yaitu Thought dan Act. Obs adalah observasi dari lingkungan yang sedang diajak berinteraksi (misalnya mesin pencari). Pada intinya, ReAct bisa mengambil informasi untuk mendukung penalaran, sementara penalaran membantu menentukan informasi apa yang perlu diambil berikutnya.
ReAct Prompting
Untuk menunjukkan cara kerja ReAct prompting, mari ikuti sebuah contoh dari paper-nya.
Langkah pertama adalah memilih kasus dari set pelatihan (misalnya HotPotQA) lalu menyusun lintasan dalam format ReAct. Lintasan ini dipakai sebagai contoh (demonstrasi) few-shot di dalam prompt. Lintasan tersebut terdiri dari beberapa langkah pemikiran-aksi-observasi (thought-action-observation) seperti yang terlihat pada gambar di atas. Pemikiran dalam bentuk bebas dipakai untuk berbagai keperluan, seperti memecah pertanyaan, mengekstrak informasi, melakukan penalaran akal sehat/aritmetika, mengarahkan perumusan pencarian, dan menyusun jawaban akhir.
Berikut gambaran seperti apa contoh (demonstrasi) dalam prompt ReAct (diambil dari paper-nya dan dipersingkat menjadi satu contoh supaya sederhana):
Question What is the elevation range for the area that the eastern sector of the
Colorado orogeny extends into?
Thought 1 I need to search Colorado orogeny, find the area that the eastern sector
of the Colorado orogeny extends into, then find the elevation range of the
area.
Action 1 Search[Colorado orogeny]
Observation 1 The Colorado orogeny was an episode of mountain building (an orogeny) in
Colorado and surrounding areas.
Thought 2 It does not mention the eastern sector. So I need to look up eastern
sector.
Action 2 Lookup[eastern sector]
Observation 2 (Result 1 / 1) The eastern sector extends into the High Plains and is called
the Central Plains orogeny.
Thought 3 The eastern sector of Colorado orogeny extends into the High Plains. So I
need to search High Plains and find its elevation range.
Action 3 Search[High Plains]
Observation 3 High Plains refers to one of two distinct land regions
Thought 4 I need to instead search High Plains (United States).
Action 4 Search[High Plains (United States)]
Observation 4 The High Plains are a subregion of the Great Plains. From east to west, the
High Plains rise in elevation from around 1,800 to 7,000 ft (550 to 2,130
m).[3]
Thought 5 High Plains rise in elevation from around 1,800 to 7,000 ft, so the answer
is 1,800 to 7,000 ft.
Action 5 Finish[1,800 to 7,000 ft]
...
Contoh ini dibiarkan dalam bahasa Inggris karena merupakan jejak asli dari paper yang mengutip isi dokumen Wikipedia berbahasa Inggris (hasil Search[...] dan Lookup[...]).
Perlu dicatat bahwa susunan prompt yang berbeda dipakai untuk jenis tugas yang berbeda. Untuk tugas yang paling mengandalkan penalaran (misalnya HotpotQA), lintasan penyelesaian tugasnya memakai banyak langkah pemikiran-aksi-observasi. Untuk tugas pengambilan keputusan yang melibatkan banyak langkah aksi, pemikiran hanya dipakai sesekali.
Hasil pada Tugas yang Padat Pengetahuan
Paper ini pertama-tama mengevaluasi ReAct pada tugas penalaran yang padat pengetahuan (knowledge-intensive), seperti menjawab pertanyaan (HotPotQA) dan verifikasi fakta (Fever). PaLM-540B dipakai sebagai model dasar untuk prompting.
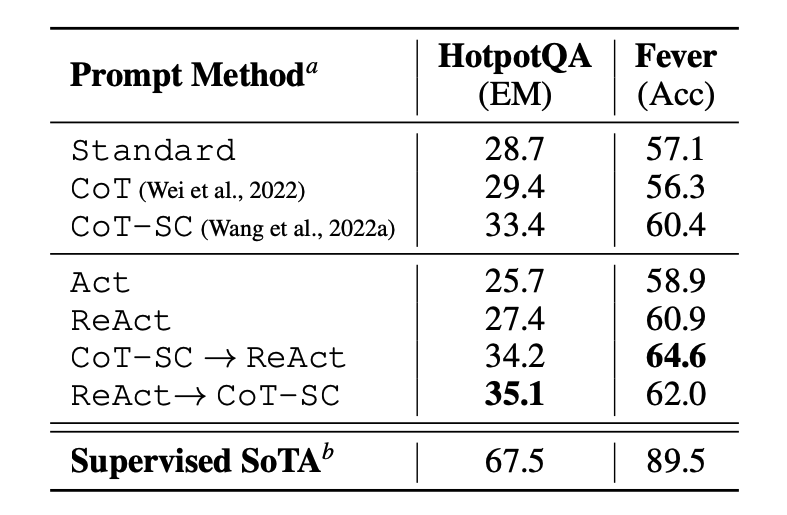
Sumber gambar: Yao et al., 2022
Hasil prompting pada HotPotQA dan Fever dengan berbagai metode prompting menunjukkan bahwa ReAct umumnya bekerja lebih baik daripada Act (yang hanya melibatkan aksi) pada kedua tugas tersebut.
Kita juga bisa melihat bahwa ReAct mengungguli CoT pada Fever, tetapi tertinggal dari CoT pada HotpotQA. Analisis kesalahan yang mendetail tersedia di paper-nya. Ringkasnya:
- CoT mengalami halusinasi fakta
- Batasan struktural ReAct mengurangi fleksibilitasnya dalam merumuskan langkah-langkah penalaran
- ReAct sangat bergantung pada informasi yang diambilnya; hasil pencarian yang tidak informatif bisa menggagalkan penalaran model dan membuatnya sulit pulih serta merumuskan ulang pemikirannya
Metode prompting yang menggabungkan dan mendukung peralihan antara ReAct dan CoT+Self-Consistency umumnya mengungguli semua metode prompting lainnya.
Hasil pada Tugas Pengambilan Keputusan
Paper ini juga melaporkan hasil yang menunjukkan performa ReAct pada tugas pengambilan keputusan. ReAct dievaluasi pada dua benchmark bernama ALFWorld (permainan berbasis teks) dan WebShop (lingkungan situs belanja online). Keduanya melibatkan lingkungan kompleks yang menuntut penalaran supaya bisa bertindak dan menjelajah secara efektif.
Perlu dicatat bahwa prompt ReAct untuk tugas-tugas ini dirancang dengan cara berbeda, tetapi tetap memegang ide inti yang sama, yaitu menggabungkan penalaran dan aksi. Di bawah ini adalah contoh soal ALFWorld yang memakai ReAct prompting.
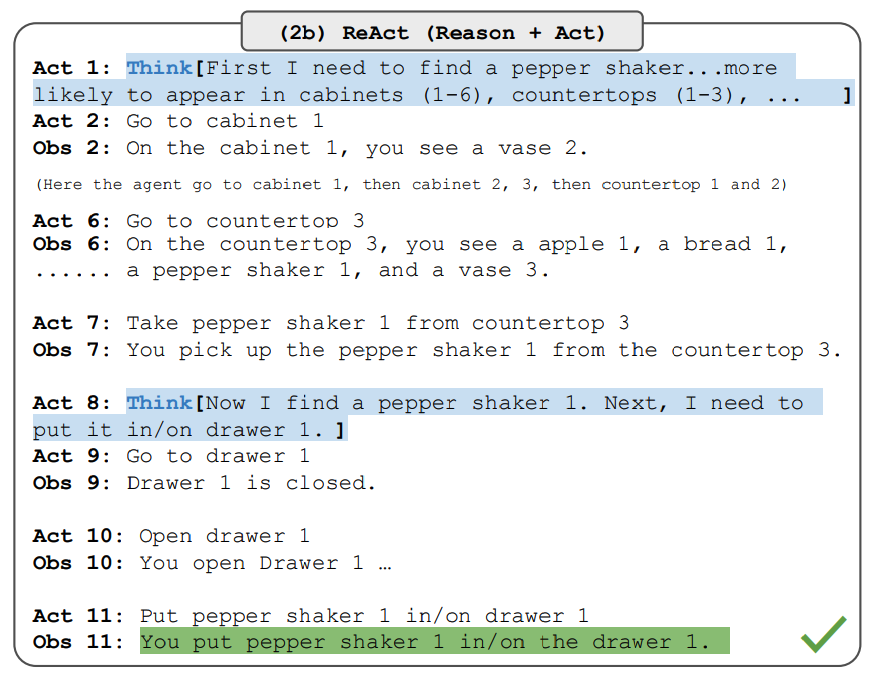
Sumber gambar: Yao et al., 2022
ReAct mengungguli Act baik di ALFWorld maupun Webshop. Act, tanpa pemikiran apa pun, gagal memecah tujuan menjadi sub-tujuan dengan benar. Penalaran tampaknya memberi keuntungan bagi ReAct untuk jenis tugas seperti ini, tetapi metode berbasis prompting yang ada saat ini masih jauh dari performa manusia ahli pada tugas-tugas tersebut.
Lihat paper-nya untuk hasil yang lebih mendetail.
Penggunaan ReAct dengan LangChain
Berikut contoh tingkat tinggi tentang cara kerja pendekatan ReAct prompting dalam praktik. Kita akan memakai OpenAI untuk LLM-nya dan LangChain, karena LangChain sudah punya fungsi bawaan yang memanfaatkan kerangka kerja ReAct untuk membangun agen yang menjalankan tugas dengan menggabungkan kekuatan LLM dan berbagai tool.
Pertama, mari instal dan impor library yang dibutuhkan:
%%capture
# update or install the necessary libraries
!pip install --upgrade openai
!pip install --upgrade langchain
!pip install --upgrade python-dotenv
!pip install google-search-results

# import libraries
import openai
import os
from langchain.llms import OpenAI
from langchain.agents import load_tools
from langchain.agents import initialize_agent
from dotenv import load_dotenv
load_dotenv()

# load API keys; you will need to obtain these if you haven't yet
os.environ["OPENAI_API_KEY"] = os.getenv("OPENAI_API_KEY")
os.environ["SERPER_API_KEY"] = os.getenv("SERPER_API_KEY")
Sekarang kita bisa mengonfigurasi LLM, tool yang akan dipakai, dan agen yang memungkinkan kita memanfaatkan kerangka kerja ReAct bersama LLM dan tool tersebut. Perhatikan bahwa kita memakai API pencarian untuk mencari informasi eksternal dan LLM sebagai tool matematika.
llm = OpenAI(model_name="text-davinci-003" ,temperature=0)
tools = load_tools(["google-serper", "llm-math"], llm=llm)
agent = initialize_agent(tools, llm, agent="zero-shot-react-description", verbose=True)
Setelah semuanya terkonfigurasi, kita bisa menjalankan agen dengan query/prompt yang diinginkan. Perhatikan bahwa di sini kita tidak perlu memberikan contoh (demonstrasi) few-shot seperti yang dijelaskan di paper.
agent.run("Who is Olivia Wilde's boyfriend? What is his current age raised to the 0.23 power?")Eksekusi rantainya (chain) terlihat seperti ini:
> Entering new AgentExecutor chain...
 I need to find out who Olivia Wilde's boyfriend is and then calculate his age raised to the 0.23 power.
Action: Search
Action Input: "Olivia Wilde boyfriend"
Observation: Olivia Wilde started dating Harry Styles after ending her years-long engagement to Jason Sudeikis — see their relationship timeline.
Thought: I need to find out Harry Styles' age.
Action: Search
Action Input: "Harry Styles age"
Observation: 29 years
Thought: I need to calculate 29 raised to the 0.23 power.
Action: Calculator
Action Input: 29^0.23
Observation: Answer: 2.169459462491557

Thought: I now know the final answer.
Final Answer: Harry Styles, Olivia Wilde's boyfriend, is 29 years old and his age raised to the 0.23 power is 2.169459462491557.

> Finished chain.
Contoh ini dibiarkan dalam bahasa Inggris karena merupakan log asli hasil menjalankan kode di atas, dengan prompt berbahasa Inggris dan hasil pencarian berbahasa Inggris.
Output yang kita dapatkan adalah sebagai berikut:
"Harry Styles, Olivia Wilde's boyfriend, is 29 years old and his age raised to the 0.23 power is 2.169459462491557."Contoh ini dibiarkan dalam bahasa Inggris karena merupakan output asli dari agen di atas.
Kami mengadaptasi contoh ini dari dokumentasi LangChain, jadi kredit sepenuhnya untuk mereka. Kami mendorong kamu untuk mencoba berbagai kombinasi tool dan tugas.
Kamu bisa menemukan notebook untuk kode ini di sini: https://github.com/dair-ai/Prompt-Engineering-Guide/blob/main/notebooks/react.ipynb